【画像から文字起こし】写真やスクショのテキストを無料・コピペ可能にするOCRツールの使い方
画像やスクリーンショットから文字を抽出する手順,認識結果の確認方法,端末内処理と初回ダウンロードについて説明します.
§サンプル画像で試す文字起こしと結果の確認
画像内の文字を手入力する手間を減らし,手軽にテキストを取り出したい場面では,ブラウザ上で動くOCR(光学文字認識)が役立ちます.ここでは実際のサンプル画像を用いて,文字起こしの操作手順,実測出力の傾向,および結果欄での校正から保存までの流れを具体的に解説します.
サンプルの準備
文字サイズや解像度の違いによる認識結果の変化を確認するため,自作のPNG画像2点を使用します.解像度1200x330の鮮明画像と,同じ画像を縮小した360x99の縮小画像です.画像に含まれる原文は以下の3行です.
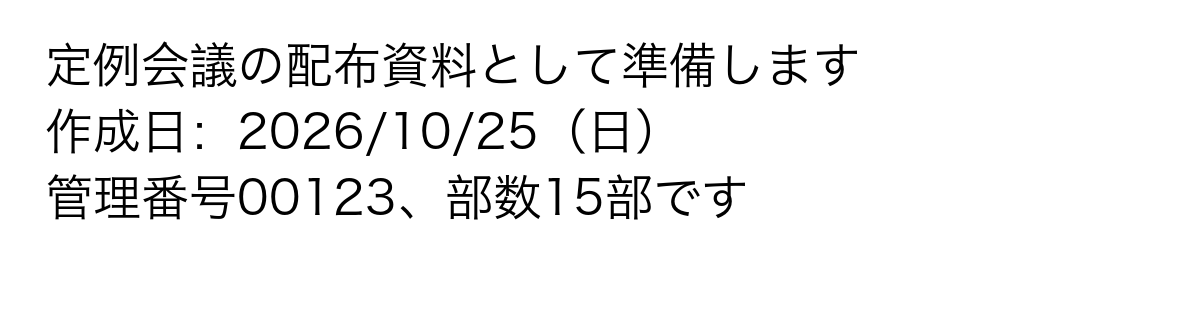
定例会議の配布資料として準備します
作成日:2026/10/25(日)
管理番号00123、部数15部です
操作の手順
1. オフラインOCRツールを開き,サンプル画像(鮮明画像または縮小画像)を読み込みます.
2. 認識言語に「日本語」ボタンで言語を指定します(サンプル画像の読み込み時は自動で日本語が選択されます).初回実行時は言語データの読み込みが発生しますが,画像解析はお使いの端末(ブラウザ内)でローカルに処理されます.
3. 「テキスト抽出を実行」をクリックして認識を開始します.
4. 抽出されたテキストを結果欄(テキストエリア)で原画像と見比べます.
5. 結果欄は直接編集できるため,不要な空白や記号のズレを手動で校正します.
6. 校正後,コピーボタンまたはtxt保存ボタンでテキストを取り出します.
結果の見方と実出力
解像度1200x330の鮮明画像と360x99の縮小画像の両方において,得られた未修正の実出力は同一であり,以下の3行となりました.
定例 会 議 の 配布 資料 と し て 準備 し ます
作成 日 : 2026/10/25 (日 )
管理 番号 00123、 部 数 15 部 で す出力ファイルの実物は鮮明画像の出力および縮小画像の出力から確認できます.今回の実測では,以下の具体的な挙動が確認できました.
- 空白の挿入: 漢字やひらがなの単語間に不要なスペースが挿入されています.
- 記号の変化: 原文の全角コロン「:」が半角コロン「:」に,全角括弧「(日)」が半角かつ空白を含む「(日 )」に変化しています.
- 先頭ゼロの保持: 管理番号「00123」の先頭ゼロは欠落せずに認識されました.
認識結果の校正と対処法
OCRの出力結果が表示されるテキストエリアは直接編集が可能です.抽出が完了したら,結果欄で原画像と照合しながら,単語間に混入した不要な空白を削除し,記号の変化を手作業で校正してください.校正済みのテキストは,そのままコピーしたりtxt保存でファイルとしてダウンロードしたりできます.もし文字の誤認識が著しい場合は,画像の解像度や傾き,コントラストを調整して再読み込みしてください.
詳しい操作手順については実践ガイドを参照してください.
補足(確認環境): 2026-10-25,macOSデスクトップのアプリ内ブラウザで確認.スマートフォン実機は未確認です.
画像内の日本語や英語をコピーしたいときは,画像文字認識・OCRで画像を選択し,文字を抽出できます.認識した結果は原画像と照合してから利用してください.
§画像から文字を抽出する手順
1. 文字が鮮明に写った画像やスクリーンショットを用意します.
2. OCRツールで画像を選び,文字に合う言語を指定します.
3. 認識を開始し,進行表示が完了するまで待ちます.初回は必要なプログラムや言語データの取得に時間がかかる場合があります.
4. 結果を原画像と見比べます.数字,日付,固有名詞,改行は特に確認してください.
5. テキストをコピーするか,.txtファイルとして保存します.
§読み取りにくい場合に確認すること
小さすぎる文字,ぼけ,影,傾き,複雑な背景は誤認識の原因になります.元の画像を鮮明なものに替える,文字部分を大きく撮影するなどして再度試してください.印刷文字向けの認識であり,手書きの正確な読み取りを保証するものではありません.
例えば「2026年9月10日」と書かれた画像なら,年・月・日の数字が欠けていないか,別の文字に置き換わっていないかを確認します.これは確認方法の例であり,実測した認識精度を示すものではありません.
§入力画像の処理と通信
このツールはTesseract.jsを用いて,選択画像の文字認識をブラウザ内で行います.OCRエンジンや言語データの取得には通信が発生します.これは入力画像を認識サーバーへアップロードする処理とは別です.
必要なデータの保存状態やブラウザによって動作条件は変わるため,すべての環境で完全オフラインになるとは保証しません.ページや広告などの読み込み通信もあります.
§抽出した文字の使い方
文章の長さを調べるなら,確認済みのテキストを文字数・行数カウンターへ貼り付けて確認できます.画像の表を抽出しても,列やセルの構造がそのまま再現されるとは限りません.